AI Router na prática: como escolher modelos e gastar menos tokens
Entenda como um AI Router escolhe modelos por demanda, aplica fallback e ajuda a equilibrar qualidade, latência, tokens, risco e custo total.
Um router útil não escolhe automaticamente o modelo mais barato. Ele escolhe o caminho mais simples que ainda cumpre o contrato da tarefa.
Usar o mesmo modelo para tudo também é uma decisão
Muitas funcionalidades com IA começam da forma mais simples possível: um endpoint, um modelo e uma configuração para qualquer solicitação. Essa escolha é boa enquanto o objetivo é aprender. Ela reduz variáveis, facilita a depuração e cria uma linha de base.
O problema aparece quando tarefas muito diferentes continuam passando pela mesma rota. Classificar uma intenção, extrair campos de um documento, responder com contexto recuperado, revisar um diff e planejar uma alteração extensa não exigem necessariamente a mesma capacidade.
Algumas operações dependem de imagem, ferramentas ou saída estruturada. Outras carregam risco maior ou precisam respeitar uma política específica de dados. Há ainda tarefas simples que não justificam a mesma latência e o mesmo custo de uma investigação complexa.
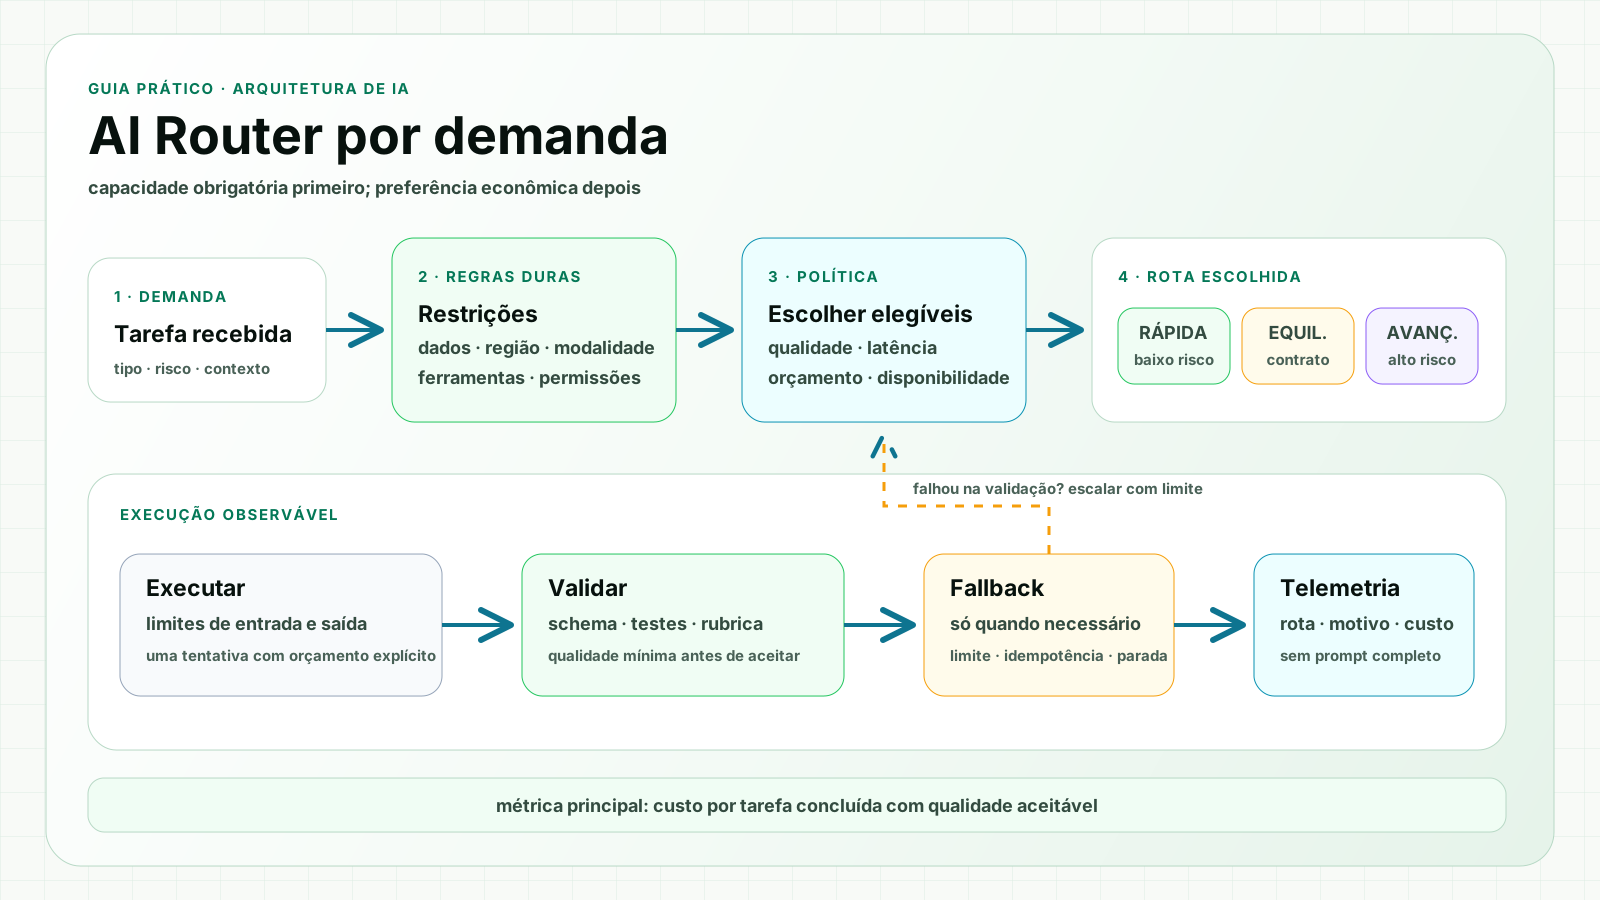
Um AI Router transforma essa diferença em política. Ele recebe sinais sobre a demanda, elimina caminhos incompatíveis, escolhe uma opção elegível e registra por que tomou aquela decisão. Se a execução falhar ou não atingir a qualidade mínima, também pode acionar um fallback controlado.
O que é um AI Router — e o que ele não é
O termo AI Router é usado para arquiteturas diferentes. Separar essas decisões evita criar uma camada confusa que faz tudo e não explica nada.
- Roteamento de modelo: qual perfil de capacidade atende esta tarefa?
- Roteamento de provedor ou implantação: qual endpoint compatível está saudável, disponível ou dentro do limite?
- Roteamento de workflow: qual cadeia, ferramenta ou agente especializado deve receber a demanda?
- Gestão de contexto: quais instruções, arquivos, trechos e resultados entram na chamada?
- Fallback: o que acontece quando a rota principal falha ou não cumpre o critério?
Um balanceador pode distribuir chamadas entre duas implantações do mesmo modelo sem entender a tarefa. Um gateway pode centralizar autenticação, limites, logs e custos sem escolher capacidade por semântica. Um fallback fixo pode trocar de endpoint depois de um erro sem realizar qualquer classificação inteligente.
As implementações atuais deixam essa diferença clara. O Amazon Bedrock prevê qualidade para rotear entre modelos compatíveis. O Cloudflare AI Gateway descreve fluxos versionados com condições, limites e fallback. O LiteLLM usa router também para balanceamento entre implantações por peso, latência, limite de taxa ou custo. Nenhuma definição é universal; antes de escolher uma ferramenta, é preciso definir qual decisão o sistema realmente deve automatizar.
Uma política mínima antes de pensar em inteligência
- Bloqueios obrigatórios: dados, região, modalidade, ferramentas e permissões.
- Elegibilidade: quais rotas conseguem cumprir o contrato técnico.
- Preferência: entre as elegíveis, qual atende melhor ao objetivo de custo, latência ou capacidade.
- Validação: como saber se a saída ficou dentro do schema e da qualidade mínima.
- Fallback: quando tentar outra rota, quando pedir revisão e quando parar.
- Telemetria: qual rota foi escolhida, por qual motivo e com qual resultado.
- Reavaliação: quando comparar novamente a política com a linha de base.
Segurança e compatibilidade vêm antes da otimização. Uma tarefa com imagem não pode seguir para uma rota apenas textual. Um fluxo que chama ferramentas exige o mesmo contrato de tool calling. Uma restrição de região não deve depender de um classificador probabilístico.
1type Route = 'rapida' | 'equilibrada' | 'avancada'23type Demand = {4 modality: 'text' | 'image'5 risk: 'low' | 'high'6 needsTools: boolean7 estimatedContextTokens: number8 previousValidationFailed: boolean9}1011function chooseRoute(demand: Demand): Route {12 if (demand.modality === 'image' || demand.needsTools) return 'equilibrada'13 if (demand.risk === 'high' || demand.previousValidationFailed) return 'avancada'14 if (demand.estimatedContextTokens < 8_000) return 'rapida'15 return 'equilibrada'16}Esse pseudocódigo não é uma política pronta para produção. Ele mostra a ordem das decisões: capacidade obrigatória primeiro; preferência econômica depois. Também trata rota como um perfil estável, evitando espalhar nomes de modelos pelo produto inteiro.
Sinais determinísticos, aprendidos e observados
Nem todo sinal precisa de IA. Metadados conhecidos costumam ser a melhor primeira fonte: tipo da operação, modalidade, ferramentas, schema, contexto estimado, região, orçamento, sensibilidade, criticidade, disponibilidade e limites de taxa.
Quando a entrada é aberta, um classificador leve pode estimar intenção, domínio ou dificuldade. Esse passo amplia a cobertura, mas cria uma nova chamada, latência e modo de falha. O classificador também pode consumir a economia que o roteamento prometia.
Regras duras cuidam de segurança e compatibilidade. Classificação entra apenas no espaço restante. Depois da execução, validação, custo e revisão mostram se a política funcionou.
Exemplo 1: consumo de IA em um sistema
Imagine uma plataforma fictícia que classifica mensagens, extrai campos de documentos e gera respostas para casos ambíguos. A alternativa à rota única pode começar com três perfis e regras simples, sem aprendizado automático.
- Classificação simples: texto, baixo risco, rota rápida, categoria permitida como validação e rota equilibrada como fallback.
- Extração documental: imagem, schema, rota multimodal equilibrada, validação de JSON e regras de campo.
- Caso ambíguo: contexto maior ou risco alto, rota avançada, rubrica com evidência e possível revisão humana.
A rota única e a política híbrida precisam usar o mesmo conjunto de casos. Se a opção rápida falha acima do limite aceitável, não basta dizer que economizou tokens. Se a extração retorna JSON válido, mas troca campos críticos, o schema sozinho também não representa sucesso.
1{2 "policy_version": "router-v3",3 "task_type": "document_extraction",4 "route": "balanced_multimodal",5 "reason_codes": ["requires_vision", "structured_output"],6 "input_tokens": 4280,7 "output_tokens": 312,8 "latency_ms": 1840,9 "validation": "passed",10 "fallback_count": 011}A telemetria registra a decisão sem armazenar o prompt inteiro. Assim, o sistema consegue explicar rota, motivo, tokens, latência e validação sem copiar indiscriminadamente documentos, código ou dados pessoais.
Exemplo 2: desenvolvimento assistido por IA
Um agente de código executa etapas com perfis diferentes: localizar arquivos, resumir saídas, planejar uma mudança, editar um ponto, investigar uma falha, executar testes e revisar uma alteração de maior risco.
Busca e triagem podem usar uma rota rápida. Planejamento com múltiplas restrições ou investigação depois de falhas repetidas pode justificar uma rota mais capaz. Uma revisão final de segurança pode ter critérios diferentes da geração inicial.
Trocar de modelo, porém, não corrige um harness mal desenhado. O agente continua precisando de acesso correto ao repositório, contexto relevante, ferramentas, permissões, testes e critérios de parada. Se ele envia arquivos demais, repete logs ou entra em loop, o router apenas escolhe quem vai processar o desperdício.
- Tipo da etapa, linguagem e framework.
- Quantidade de arquivos, tamanho e risco do diff.
- Necessidade de terminal ou outras ferramentas.
- Falhas de validação anteriores.
- Criticidade da área alterada.
O roteamento também precisa preservar continuidade. Trocar de provedor ou modelo no meio da tarefa pode reduzir aproveitamento de cache, alterar ferramentas e exigir adaptação do contexto. A economia de uma etapa isolada pode desaparecer no custo da trajetória completa.
O router ajuda a gastar melhor; ele não reduz tokens sozinho
O router pode decidir qual perfil processa cada etapa, quando escalar capacidade, quantas tentativas são permitidas e quais limites de entrada, saída ou raciocínio valem para cada rota. Ele também pode escolher entre chamada direta, lote, execução assíncrona ou workflow especializado.
- Não corrige contexto excessivo ou mal selecionado.
- Não remove resultados de ferramentas repetidos.
- Não aproveita cache automaticamente quando os prefixos mudam.
- Não limita respostas longas sem uma política de saída.
- Não interrompe loops sem critério de parada.
- Não evita retries causados por baixa qualidade.
- Não substitui idempotência em chamadas com efeito colateral.
Gestão de contexto, prompt caching, limites de saída e desenho do workflow continuam sendo controles próprios. Prefixos estáveis podem reduzir processamento e custo de entrada em cache hits, mas escolher outro modelo não torna automaticamente o contexto menor nem reutilizável.
A estratégia de tentar uma rota barata e escalar se falhar pode executar duas chamadas em todos os casos difíceis. Se a primeira tentativa quase nunca passa na validação, o sistema aumenta tokens e latência em vez de economizar.
1custo total da tarefa =2 decisão do router3 + execução principal4 + validação5 + retries6 + fallbacks7 + revisão humana necessáriaA métrica mais útil é custo por tarefa aprovada, não preço por token nem porcentagem de chamadas enviadas para a rota menor.
Fallback não pode significar repetir sem limite
Fallback ajuda na disponibilidade e na degradação controlada. Também pode duplicar trabalho, esconder incidentes e repetir operações com efeito colateral. Antes de tentar outra rota, o sistema precisa distinguir erro transitório de falha determinística, verificar compatibilidade, idempotência e orçamento de tempo e tentativas.
Uma falha de rate limit pode justificar outra implantação. Um schema incompatível pode exigir outra capacidade ou correção do pedido. Uma violação de política não deve ser contornada automaticamente por outro provedor. Retries do router e retries internos do SDK também precisam de um único responsável para não multiplicar chamadas.
O que medir para saber se a política funciona
- Qualidade por critério e taxa de conclusão.
- Custo por tarefa concluída.
- Latência total e percentis.
- Tokens do router e da rota escolhida.
- Frequência e custo de retries e fallbacks.
- Erro de roteamento por tipo de demanda.
- Taxa de revisão humana e disponibilidade por rota.
- Violações de schema ou contrato de ferramentas.
A comparação deve começar com uma rota única, avançar para regras determinísticas e só então testar uma estratégia híbrida se necessário. Resultados precisam ser segmentados por tarefa, incluindo o custo e o impacto dos erros do próprio router.
Evals funcionam como contrato operacional: descreva a tarefa, execute entradas representativas e analise o resultado para iterar. O conjunto deve cobrir casos comuns e fronteiras, incluindo dados sensíveis, contexto grande, falha de ferramenta e indisponibilidade.
Quando manter uma única rota é mais maduro
- Um modelo atende às tarefas relevantes dentro do orçamento.
- O volume ainda é baixo ou a distribuição de demandas é desconhecida.
- Não existem evals ou critérios de qualidade.
- O sistema não registra custo e latência por tarefa.
- As rotas candidatas não são compatíveis em formato, ferramentas ou política de dados.
- A equipe ainda não consegue explicar e operar a política.
Adicionar classificador, múltiplos provedores, fallback e telemetria antes de entender o problema cria complexidade sem evidência de retorno. Uma rota única observável é melhor do que um router sofisticado que ninguém consegue validar.
Um experimento pequeno e reversível
- Escolha uma família de tarefa repetida, com volume e critério de sucesso conhecidos.
- Registre qualidade, latência, tokens, custo, retries e revisão da rota atual.
- Defina apenas duas rotas compatíveis: uma referência e uma alternativa mais simples.
- Comece por regras determinísticas; classifique apenas ambiguidades relevantes.
- Valide antes do fallback, limite tentativas e proteja efeitos colaterais com idempotência.
- Rode em sombra ou amostra pequena, com política versionada e rollback simples.
- Decida por qualidade e custo da tarefa concluída, não por chamada isolada.
Checklist prático
- A tarefa e o critério de sucesso estão definidos.
- Existe uma linha de base com rota única.
- Segurança, região, modalidade e permissões são bloqueios explícitos.
- Todas as rotas elegíveis cumprem schema e contrato de ferramentas.
- O custo do classificador, da validação e dos fallbacks entra na conta.
- Retries têm limite e responsável único.
- Operações com efeito colateral são idempotentes ou protegidas.
- O motivo da decisão é registrado sem conteúdo sensível em excesso.
- A política tem versão, rollout gradual e rollback.
- Evals cobrem casos comuns, fronteiras e falhas.
- A comparação usa custo por tarefa concluída.
- Modelos, preços, limites e distribuição serão revistos periodicamente.
Limites e ressalvas
Ferramentas de mercado implementam recortes diferentes de roteamento. Modelos suportados, regiões, preços, limites e disponibilidade mudam. Os exemplos deste artigo mostram diferenças de arquitetura; não são indicação de fornecedor.
Também não existe sinal universal de dificuldade. Tamanho do prompt, intenção ou quantidade de arquivos podem ajudar, mas nenhum substitui evals no domínio real. Um classificador treinado com tráfego antigo pode ficar desatualizado quando produto, modelos ou usuários mudam.
Reduzir tokens também não significa necessariamente reduzir custo total. Latência, taxa de erro, engenharia operacional, revisão humana, armazenamento, observabilidade e incidentes fazem parte da decisão.
Conclusão
Um AI Router é uma política operacional, não uma máquina automática de economia. Ele ajuda quando torna explícito quais caminhos cumprem a tarefa, quais sinais mudam a decisão, como a saída é validada e o que acontece quando a rota principal falha.
O melhor começo não é adicionar muitos modelos. É criar uma rota única observável, entender a distribuição das tarefas e escolher um caso em que duas capacidades realmente façam sentido. Depois disso, use a opção mais simples que atende ao contrato, escale com critério e meça o custo da tarefa completa.
Gastar menos tokens pode ser consequência. O objetivo é gastar capacidade onde ela muda o resultado.