Planejamento, ferramentas e contexto: o que realmente muda o desempenho de agentes de código?
Entenda como planejamento, ferramentas e gestão de contexto afetam agentes de código e por que o melhor harness depende do modelo, da tarefa e do orçamento.
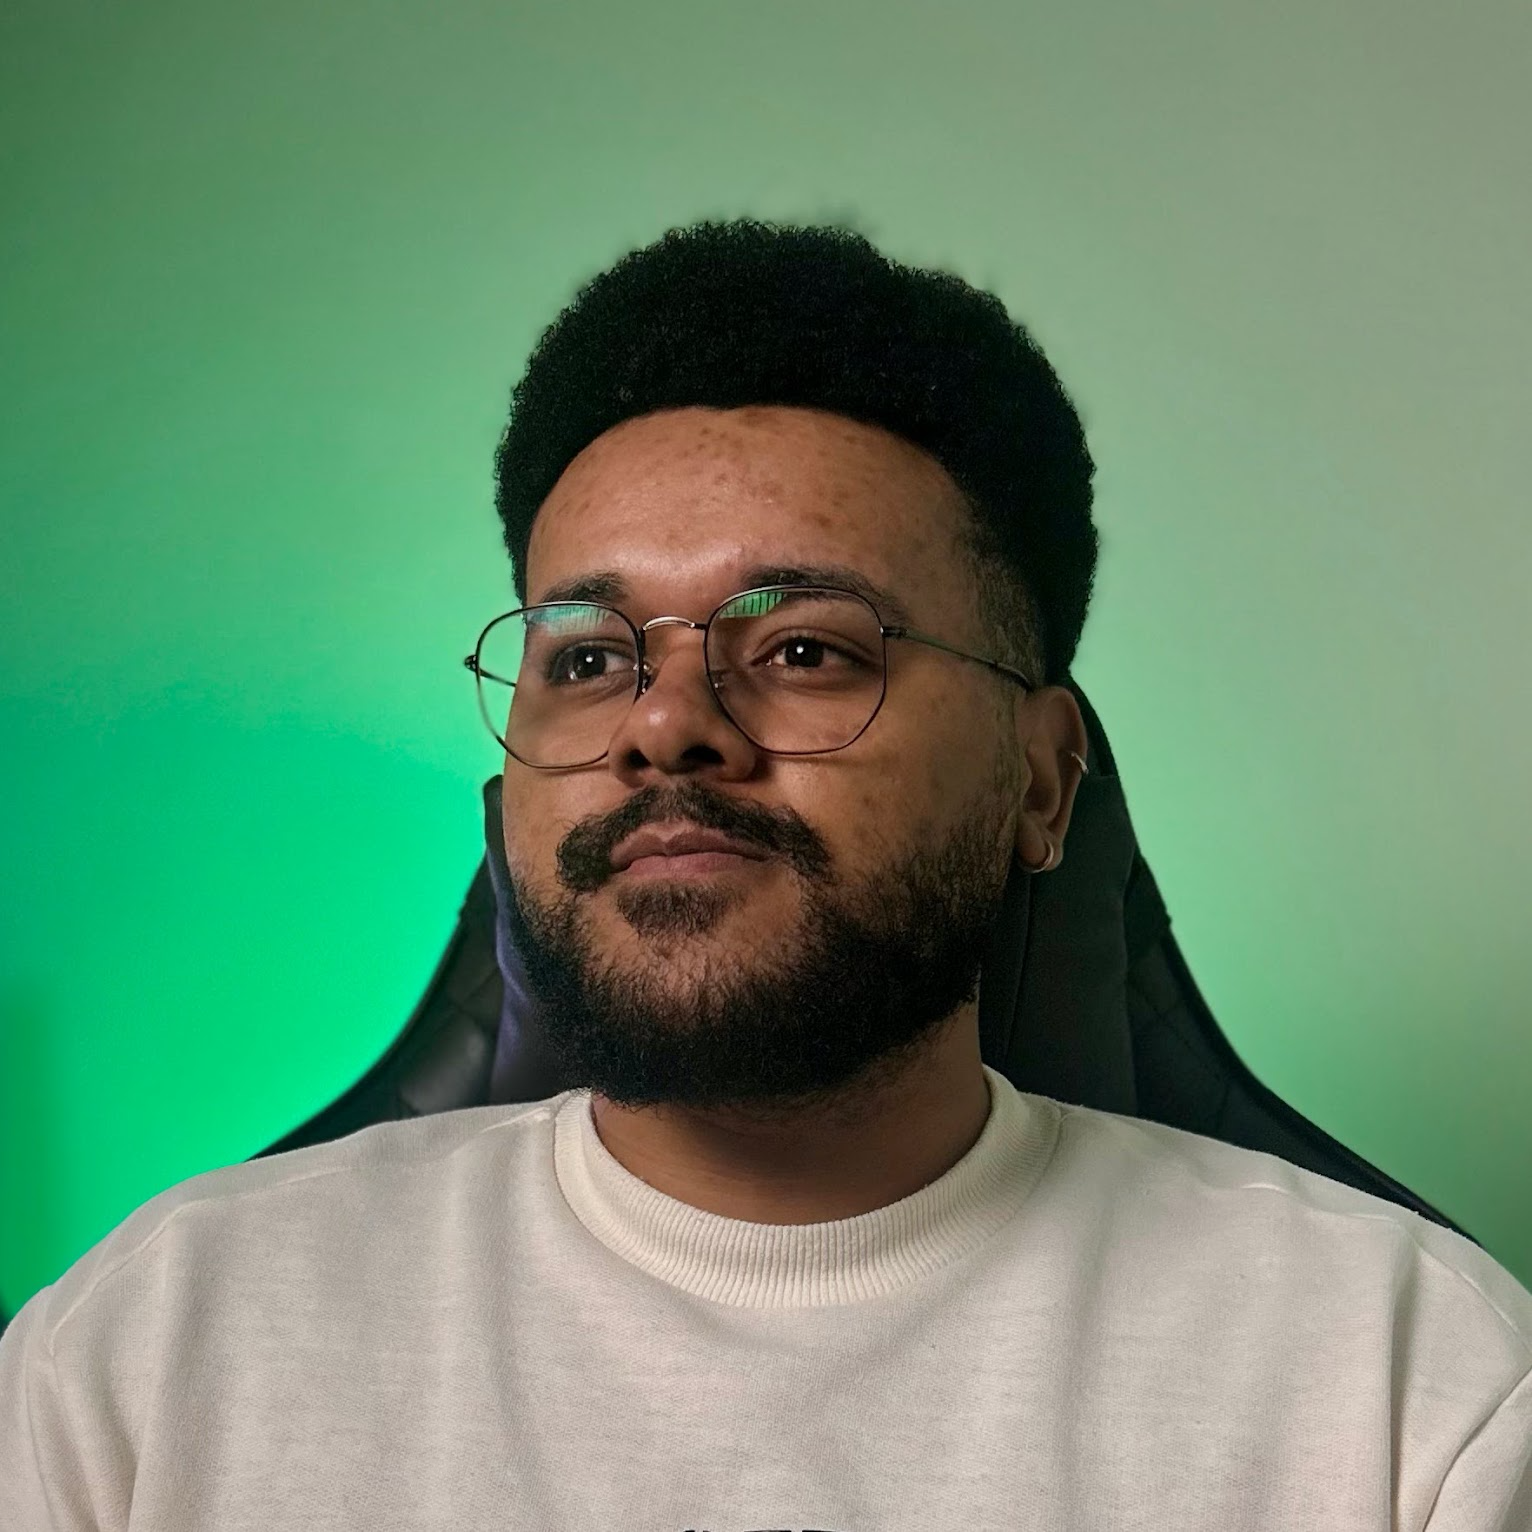
O modelo não trabalha sozinho. Planejamento, interface de ações e gestão de contexto moldam a trajetória do agente, mas nenhum desses componentes é uma melhoria automática.
Quando um agente de código resolve uma tarefa difícil, é comum atribuir o resultado ao modelo. Quando ele falha, a primeira reação também costuma ser trocar de modelo ou aumentar a janela de contexto.
Essa explicação é incompleta. Entre a solicitação e o código existe uma camada que decide quais instruções o agente recebe, quais ferramentas pode usar, como acompanha o plano, quais resultados permanecem no contexto, como uma edição é validada e quando a execução deve parar.
Essa camada é o coding harness: a estrutura operacional que transforma a capacidade geral de um modelo em um processo de engenharia de software. Dois agentes com o mesmo modelo podem se comportar de formas diferentes porque oferecem interfaces, políticas de contexto, validações e critérios de continuidade diferentes.
O que o estudo tentou separar
O preprint An Empirical Study of Harness Design for Coding Agents chamou minha atenção porque, em vez de comparar produtos completos, tenta isolar três decisões: planejamento persistente, espaço de ações e gestão de contexto em tarefas extensas.
Os autores construíram um harness leve com loop de execução fixo. Permissões, diagnósticos depois de edições e detecção de repetição permaneceram constantes, enquanto os três componentes foram alterados separadamente.
- Quatro modelos: Nemotron-3 30B, 120B e 550B, além de Mistral-Medium-3.5-128B.
- Dois benchmarks de tarefas longas: SWE-Bench Verified e Terminal-Bench 2.1.
- Cinco estratégias de gestão de contexto.
- Janelas de 32k, 64k, 96k e 128k tokens.
- 176 configurações experimentais com métricas de sucesso, custo e comportamento das trajetórias.
Em 7 de outubro de 2026, o trabalho continuava como preprint v1, enviado ao arXiv em 17 de setembro. Ele não cobre todo o universo de agentes; oferece evidência controlada sobre implementações específicas. Essa diferença impede que um resultado condicional vire regra geral.
Gestão de contexto ajuda o agente a continuar
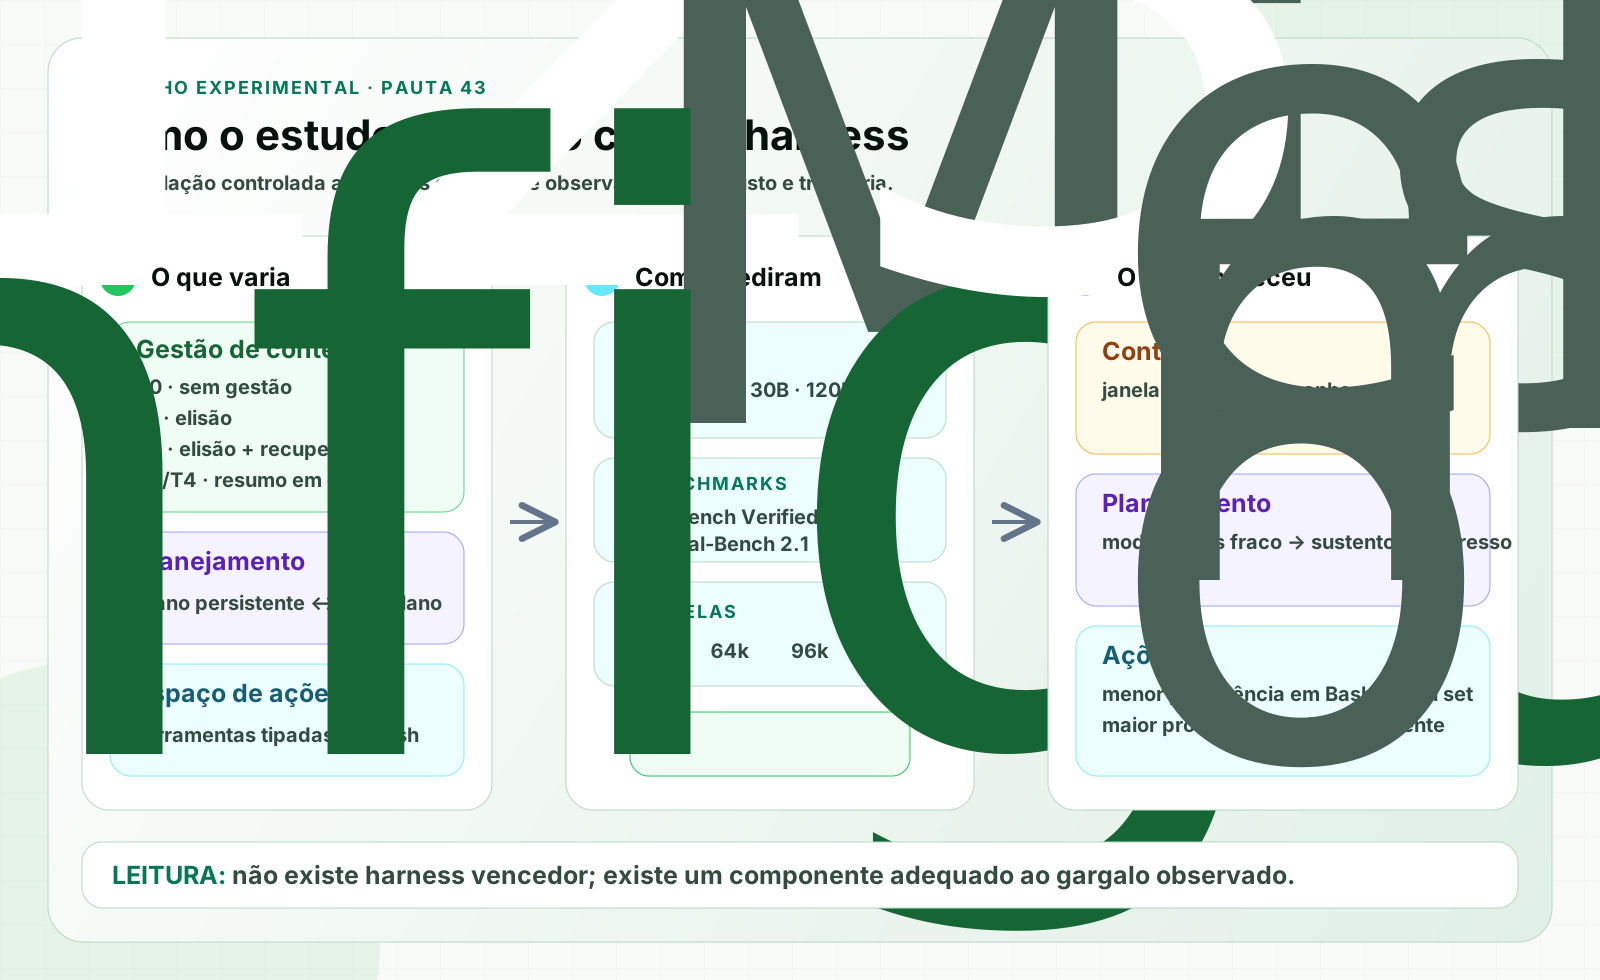
Uma tarefa longa acumula instruções, leituras de arquivos, resultados de busca, logs, erros, diffs e saídas de testes. Mesmo quando cada passo é útil, o histórico pode crescer até ocupar a janela disponível.
- `T0`: nenhuma compactação adicional; a execução termina se o histórico exceder a janela.
- `T1`: elisão de observações antigas de ferramentas.
- `T2`: elisão com armazenamento externo e possibilidade de recuperar o conteúdo removido.
- `T3`: sumarização por LLM, sem elisão anterior.
- `T4`: elisão, armazenamento recuperável e sumarização em etapas.
Elisão significa substituir uma saída antiga e volumosa por um marcador curto. Na estratégia T4, a sumarização só entra quando essa redução determinística ainda não é suficiente.
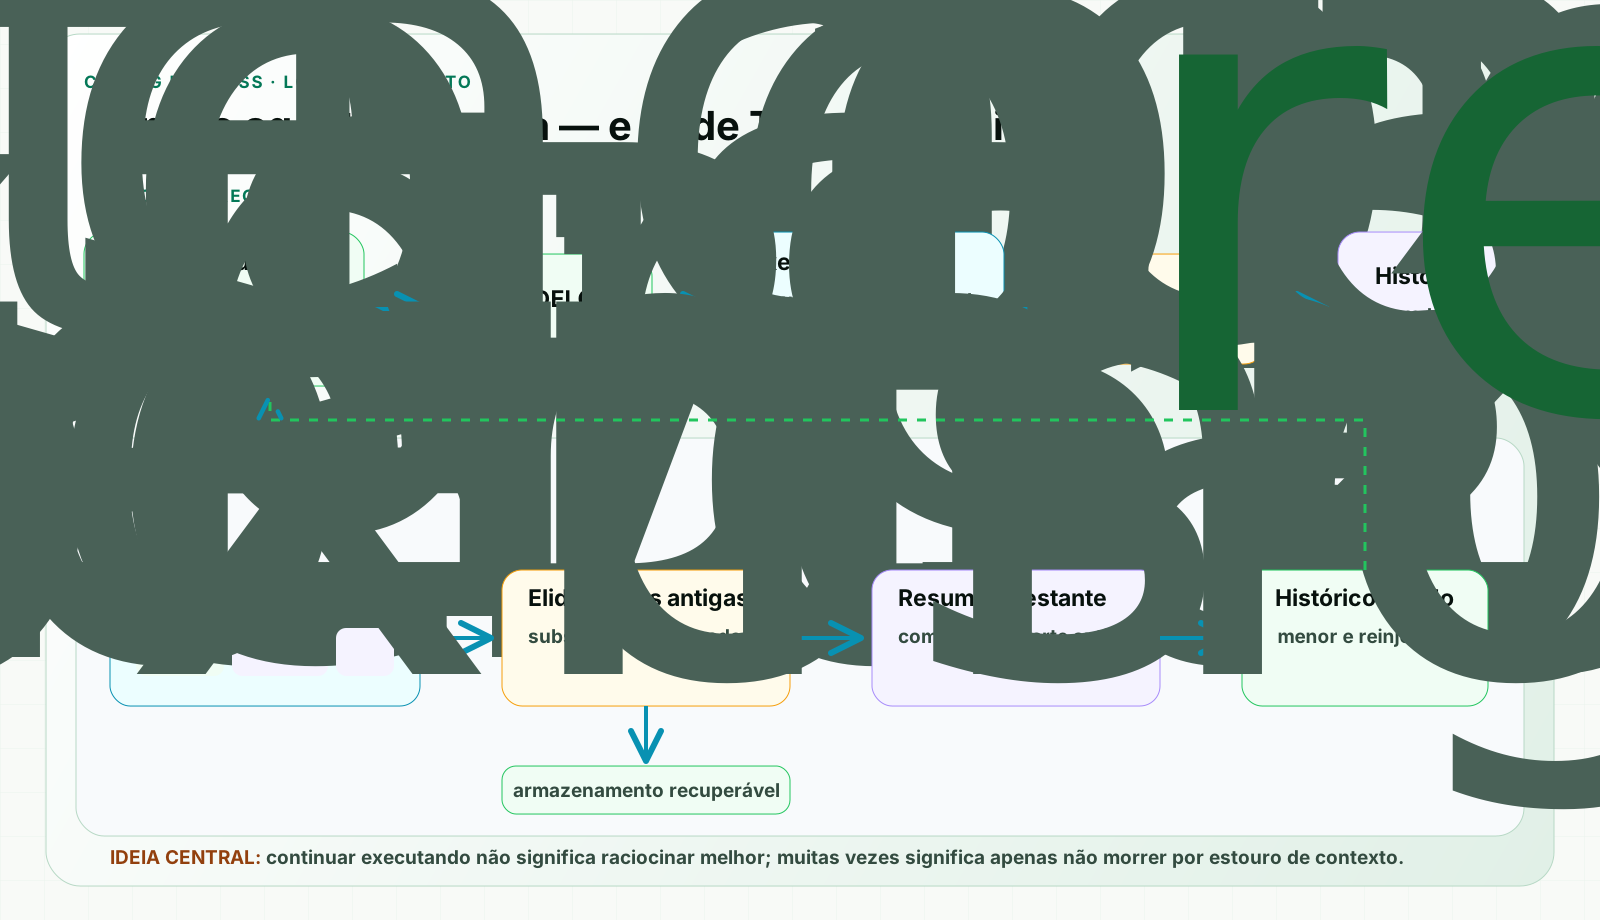
O benefício apareceu com mais força nas janelas menores. Grande parte do ganho veio de evitar que a execução terminasse cedo por estouro de contexto. Isso não significa necessariamente que o agente passou a raciocinar melhor; muitas vezes, ele apenas conseguiu chegar à edição e à verificação.
No estudo, elidir observações antigas antes de recorrer à sumarização apresentou o melhor equilíbrio agregado de eficiência entre as estratégias avaliadas.
Memória recuperável só ajuda quando o agente a usa
Tornar observações removidas recuperáveis parece uma melhoria óbvia. O estudo, porém, encontrou uso muito baixo do mecanismo de recuperação e nenhum ganho de precisão sobre a elisão isolada nas configurações comparadas.
Isso não prova que memória externa é inútil. Mostra que disponibilizar uma ferramenta não garante que o agente reconheça quando precisa dela. Ele precisa perceber que uma informação voltou a ser relevante, localizar o item correto e usar a recuperação para mudar a próxima decisão.
Planejamento pode ser apoio ou redução de desperdício
Planejamento no estudo não foi um pedido genérico para o modelo pensar antes de agir. Foi uma representação persistente do progresso, atualizada por uma ferramenta e reinjetada a cada turno.
Para o modelo mais fraco avaliado, o plano ajudou a sustentar a trajetória até uma tentativa de edição, melhorando o sucesso com custo adicional. Nos modelos mais fortes, o efeito principal foi reduzir verificações repetidas depois da edição, com pequenas mudanças de precisão.
- Hipótese atual.
- Arquivos relevantes e evidência encontrada.
- Alteração realizada.
- Validação pendente.
- Próximo passo.
Um plano útil registra estado de trabalho. Se não muda decisões, não reduz repetição e não ajuda a retomar a tarefa, ele pode ser apenas mais contexto para carregar.
Ferramentas predefinidas versus Bash não tem vencedor universal
Ferramentas tipadas oferecem operações como ler, buscar e editar arquivos por argumentos estruturados. Uma interface baseada em Bash permite combinar várias operações em um comando e pode reduzir o número de interações.
No estudo, ferramentas predefinidas ajudaram modelos com menor proficiência em Bash. Modelos mais capazes nesse ambiente trabalharam bem por Bash e, principalmente em tarefas centradas em terminal, combinaram operações com custo menor.
Isso não significa que modelos fortes não precisam de ferramentas. A comparação modificou a interface completa: as ferramentas predefinidas também ofereciam instruções, controle de estado, validação de escrita e diagnósticos automáticos. O experimento não isolou apenas quantidade de ferramentas ou granularidade das ações.
- Capacidade: o modelo consegue expressar a ação corretamente?
- Segurança: permissões e limites continuam explícitos?
- Observabilidade: é possível entender o que foi executado e por quê?
- Eficiência: quantas interações e tokens foram necessários?
Bash pode ser uma interface poderosa sem ser uma autorização irrestrita. Ferramentas tipadas podem oferecer proteção valiosa sem fragmentar cada operação em chamadas pequenas demais.
Exemplo: investigar uma falha com logs extensos
Imagine um agente corrigindo uma falha de integração em um repositório grande. Ele precisa localizar o fluxo, reproduzir o erro, editar o código e executar uma suíte de testes que produz milhares de linhas.
1localizar arquivos2 -> reproduzir a falha3 -> registrar hipótese4 -> editar código5 -> executar testes6 -> analisar falha residual7 -> ajustar implementação8 -> validar novamenteTrês problemas diferentes podem parecer uma única falha do modelo: o agente abandona a investigação antes de editar; resultados antigos de testes ocupam a janela; ou a interface exige tantas chamadas pequenas que o custo cresce antes da validação.
- Resultado: a tarefa foi concluída e validada?
- Término: o agente parou por conclusão, limite, contexto, erro ou repetição?
- Progresso: chegou a localizar, reproduzir, editar e verificar?
- Contexto: quais saídas ocuparam mais espaço?
- Plano: o estado persistente mudou decisões ou evitou repetição?
- Ações e custo: quantas chamadas, falhas e tokens foram necessários?
Eu não mudaria tudo ao mesmo tempo. Se a maioria das trajetórias morre por contexto, testaria elisão de logs antigos antes de sumarização. Se o agente para antes da primeira edição, avaliaria um plano persistente. Se há excesso de chamadas e o modelo domina shell, compararia uma interface mais composta sem remover controles de segurança.
Um framework simples para avaliar o harness
1. Defina a tarefa e a linha de base
Escolha tarefas representativas, critérios de sucesso e uma configuração inicial. Sem linha de base, qualquer mudança pode parecer melhoria.
2. Instrumente a trajetória
Registre etapas, ferramentas, tamanho do contexto, motivo de término, validações, retries e custo. A resposta final sozinha não explica onde o sistema falhou.
3. Classifique o gargalo
- Abandono antes da ação útil.
- Erro de ferramenta ou permissão.
- Contexto excedido.
- Edição incorreta.
- Verificação ausente ou repetitiva.
- Conclusão declarada sem evidência suficiente.
4. Altere um componente observável
Teste planejamento, política de contexto ou interface de ações de forma isolada sempre que possível. Se todos mudam juntos, o resultado volta a ser uma comparação entre caixas-pretas.
5. Compare sucesso e custo por tarefa concluída
Uma intervenção pode aumentar a taxa de sucesso e também o custo. Outra pode reduzir chamadas sem preservar qualidade. A decisão precisa observar o resultado aceito, não apenas tokens ou quantidade de passos.
O que eu levaria desse estudo
- Mais contexto não elimina a necessidade de gerir contexto; apenas adia o limite.
- Planejamento, memória e ferramentas devem resolver gargalos identificados, não entrar como ritual.
- Capacidade do modelo e design da interface interagem; um apoio útil para um modelo pode adicionar atrito para outro.
- Analisar a trajetória revela mais do que olhar apenas para o sucesso final.
Limites e ressalvas
- O trabalho é um preprint, não um consenso definitivo.
- Foram avaliados quatro modelos, sendo três tamanhos da mesma família.
- Os benchmarks foram SWE-Bench Verified e Terminal-Bench 2.1; o primeiro é restrito a Python.
- Planejamento e espaço de ações foram testados apenas com T4 e janela de 128k.
- Cada configuração foi executada uma vez por tarefa, e Terminal-Bench contém 89 tarefas.
- Tamanho do modelo é uma aproximação imperfeita de capacidade.
- A comparação de ferramentas combina schemas, prompts, estado e diagnósticos.
- Custos dependem dos modelos, preços e condições do experimento.
Os pontos de cruzamento encontrados não devem ser transportados diretamente para outro modelo, repositório ou harness. Eles servem para formar hipóteses que ainda precisam ser validadas no ambiente real.
Conclusão
Planejamento, ferramentas e gestão de contexto moldam a forma como um agente transforma capacidade em trabalho concluído. Um bom harness não é o que acumula mais camadas, mas o que torna o gargalo observável, aplica uma intervenção adequada e permite verificar se sucesso, custo e segurança realmente melhoraram.
Antes de trocar de modelo ou adicionar mais memória, eu começaria pela trajetória: onde o agente para, o que ocupa o contexto, quais ações falham e quais passos se repetem. Essa análise costuma indicar com mais precisão qual parte do sistema precisa mudar.