Guia prático de filas e workers para tarefas demoradas com IA
Entenda quando usar filas e workers em tarefas com IA, como modelar estados, idempotência, retries, concorrência e cancelamento e quando manter uma chamada direta.
Fila não deixa a IA mais inteligente nem mais rápida. Ela transforma uma execução demorada em um trabalho identificável, observável e recuperável.
Uma integração com IA costuma começar dentro de uma requisição HTTP: o frontend envia dados, a API chama o modelo e devolve a resposta. Para uma tarefa curta e previsível, esse caminho é fácil de entender, testar e operar.
O problema aparece quando o trabalho demora, envolve vários arquivos, depende de ferramentas externas ou falha de forma transitória. A conexão pode expirar, a pessoa pode fechar a página e uma nova tentativa pode repetir uma operação cara. Nesse cenário, separar solicitação e processamento começa a fazer sentido.
Mas fila não é um botão de escala. Ela introduz componentes, estados e novos modos de falha. A pergunta útil não é “usa IA, então precisa de worker?”, mas “a tarefa precisa continuar existindo e ser recuperável independentemente da requisição que a iniciou?”.
Quando uma chamada direta ainda é suficiente
- A duração cabe com folga no tempo esperado pela interface e pela infraestrutura.
- A operação tem poucas etapas e não precisa sobreviver ao fechamento da página.
- Uma falha pode ser mostrada e repetida sem efeito colateral relevante.
- O volume e a concorrência são baixos ou previsíveis.
- Não existe resultado parcial, retomada ou cancelamento que precise ser preservado.
- A complexidade operacional de uma fila seria maior do que o problema.
Antes de criar uma fila, eu mediria o fluxo real. Se a maior parte das solicitações termina de forma estável e rápida, talvez um timeout bem definido, feedback adequado e tratamento de erro já resolvam o problema.
Sinais de que o processamento assíncrono pode ajudar
- A tarefa frequentemente ultrapassa o tempo confortável de uma requisição.
- O processamento possui várias etapas ou um lote de itens independentes.
- Falhas transitórias precisam de retry controlado.
- A aplicação precisa limitar concorrência, custo ou consumo por usuário.
- A pessoa deve poder sair da página e retornar depois.
- Resultados parciais, retomada, cancelamento ou reprocessamento têm valor.
- O sistema precisa absorver picos sem enviar tudo ao provedor ao mesmo tempo.
A resposta HTTP aceita o trabalho, não promete o resultado
Quando o processamento seguirá em background, a API pode responder com `202 Accepted`, um identificador e uma URL de acompanhamento. Esse status comunica que a solicitação foi aceita, mas ainda pode falhar, ser cancelada ou até não ter começado. O contrato da interface precisa refletir essa diferença.
1{2 "jobId": "job_123",3 "status": "queued",4 "statusUrl": "/jobs/job_123"5}O fluxo mínimo de um job
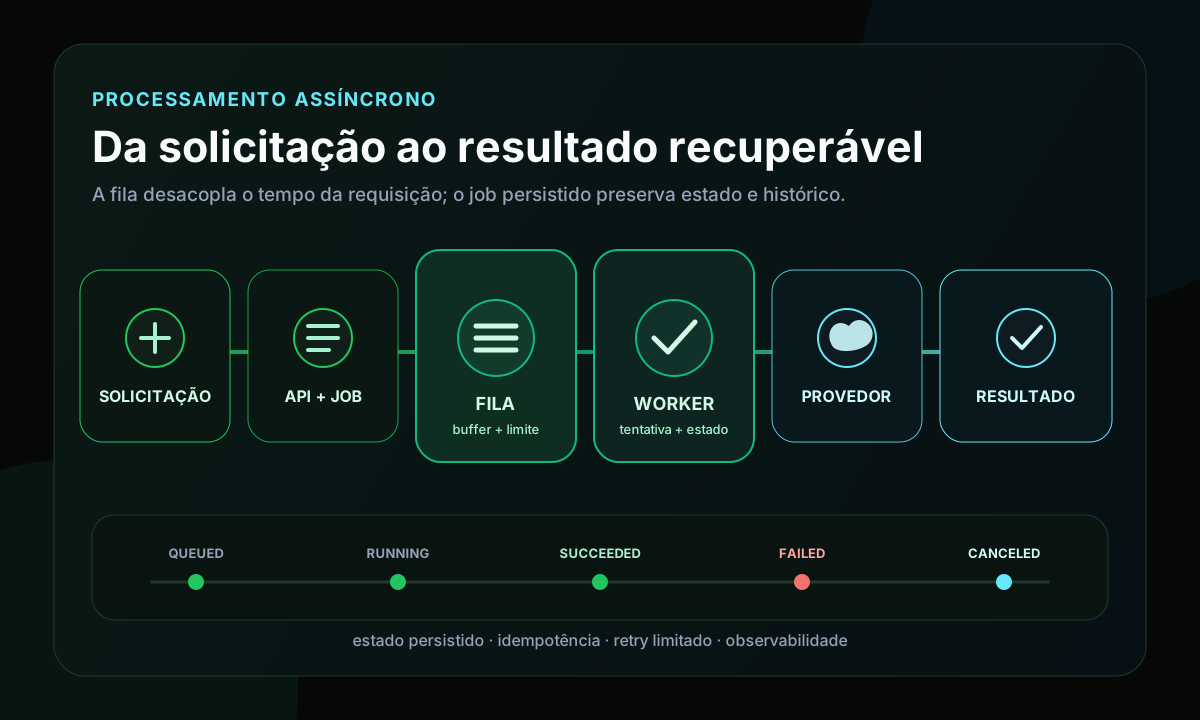
- O frontend envia a solicitação.
- A API valida autenticação, permissão, formato e limites.
- A aplicação cria um job com identificador e estado `queued`.
- Uma mensagem pequena referencia esse job na fila.
- Um worker reserva a mensagem e muda o estado para `running`.
- O worker executa o trabalho, valida e persiste o resultado.
- O job termina como `succeeded`, `failed` ou `canceled`.
- A interface consulta ou recebe atualizações do estado persistido.
Estados precisam representar fatos
- `queued`: aceito e aguardando capacidade.
- `running`: reservado por um worker e em processamento.
- `succeeded`: resultado validado e disponível.
- `failed`: terminou sem resultado aceitável.
- `cancel_requested`: cancelamento solicitado, ainda não confirmado.
- `canceled`: processamento interrompido ou ignorado com segurança.
Em um lote, o estado geral não precisa apagar o estado de cada item. Um job pode terminar com erros parciais e ainda preservar resultados válidos. Transições também precisam ser controladas: uma tarefa concluída não deve voltar silenciosamente para `running`, e um retry precisa deixar histórico.
Idempotência vem antes de retry
A garantia de entrega depende do broker e da configuração. Filas comuns podem entregar a mesma mensagem novamente após falhas ou atrasos de confirmação. Por isso, o consumidor deve ser projetado conforme o contrato real e, quando duplicatas forem possíveis, repetir a mesma intenção não pode gerar cobrança, gravação ou ação duplicada.
- Use uma chave de idempotência na criação do job.
- Verifique o estado antes de iniciar ou repetir uma etapa.
- Use lease ou bloqueio com expiração quando necessário.
- Persista resultados por etapa para permitir retomada.
- Proteja efeitos externos contra repetição.
- Repita apenas falhas recuperáveis, com limite e backoff.
Retry sem idempotência transforma uma falha transitória em risco de trabalho e custo duplicados.
Concorrência e custo continuam existindo
Uma fila absorve um pico, mas não elimina o trabalho. Se dez mil tarefas entram em poucos minutos, elas ainda precisam ser processadas. Quando a taxa média de entrada supera a capacidade de consumo, a fila cresce e a espera aumenta.
- Limites do provedor e dos serviços internos.
- Orçamento por período, usuário ou funcionalidade.
- Quantidade de jobs simultâneos e tamanho dos lotes.
- Profundidade da fila e idade do job mais antigo.
- Tempo máximo, expiração e políticas de cancelamento.
- Taxa de erro, retries e custo por tarefa concluída.
A interface não pode esconder o processamento
Trocar uma chamada direta por uma fila muda o contrato da experiência. A tela precisa informar que a solicitação foi recebida, se está aguardando ou processando, se existe progresso verificável, se a pessoa pode sair e voltar, como cancelar e o que aconteceu quando uma parte falhou.
Polling, eventos enviados pelo servidor ou notificações são formas de transportar atualizações. Nenhuma delas substitui a fonte de verdade persistida. Cancelamento também precisa ser honesto: mudar a tela para “cancelado” não interrompe automaticamente uma chamada externa já em andamento.
Exemplo: análise de vários documentos
Imagine uma tarefa que recebe dez documentos e extrai dados estruturados. A API valida tipos, tamanhos, permissões e quantidade, cria um job idempotente e registra dez itens pendentes. A mensagem na fila carrega apenas o identificador necessário, evitando copiar documentos ou dados sensíveis.
O worker reserva alguns itens conforme o limite de concorrência e registra cada tentativa. A saída passa por validação de schema. Uma indisponibilidade pode gerar retry com backoff; um arquivo inválido produz erro definitivo e legível. A interface mostra `7 de 10 concluídos`, preserva os sete resultados e permite repetir somente os itens corrigidos.
Observabilidade e segurança
- Quantos jobs estão aguardando e há quanto tempo?
- Qual etapa concentra falhas e retries?
- Quanto custa uma tarefa concluída?
- Quais jobs ficaram presos em `running`?
- Existe origem, usuário ou payload gerando saturação?
- O cancelamento realmente impediu novas etapas?
Logs devem usar identificadores de correlação e evitar prompts, documentos ou respostas completas por padrão. O worker pode precisar revalidar autorização, porque estar na fila não transforma uma permissão antiga em acesso permanente. Jobs, resultados e logs também precisam de retenção compatível com a necessidade de recuperação e a sensibilidade dos dados.
Checklist de decisão
- A tarefa realmente ultrapassa o limite confortável de uma requisição?
- Precisa continuar depois que a pessoa sai da página?
- Retry, resultado parcial ou retomada criam valor?
- Existe uma unidade de trabalho com estados definidos?
- A operação pode ser repetida com segurança?
- Concorrência e orçamento têm limites explícitos?
- A interface consegue acompanhar, cancelar e recuperar?
- Logs e métricas cobrem fila e worker?
- Dados no payload, resultado e logs foram minimizados?
- O benefício compensa a complexidade operacional?
Limites e conclusão
Fila não garante processamento exatamente uma vez, não corrige falta de idempotência e não resolve uma integração instável por si só. Alguns fluxos podem usar processamento assíncrono sem um broker dedicado; outros precisam de orquestração mais avançada. A arquitetura deve crescer com requisitos e falhas observados.
Quando estado, idempotência, limites e experiência de acompanhamento ainda não estão definidos, adicionar um broker apenas desloca o problema. Quando esses elementos são necessários, fila e worker criam uma separação valiosa entre receber a intenção e concluir o trabalho com segurança.